Eigen onderzoek van AiLabo.eu
Hoe betrouwbaar is AI als er maar één juist antwoord mogelijk is?
Hoe betrouwbaar zijn ChatGPT, Gemini, Claude en Perplexity wanneer we ze geen creatieve opdracht geven, maar vragen naar feiten die achteraf objectief gecontroleerd kunnen worden? Dat is precies wat we met onze reeks Feit of Fictie onderzoeken.
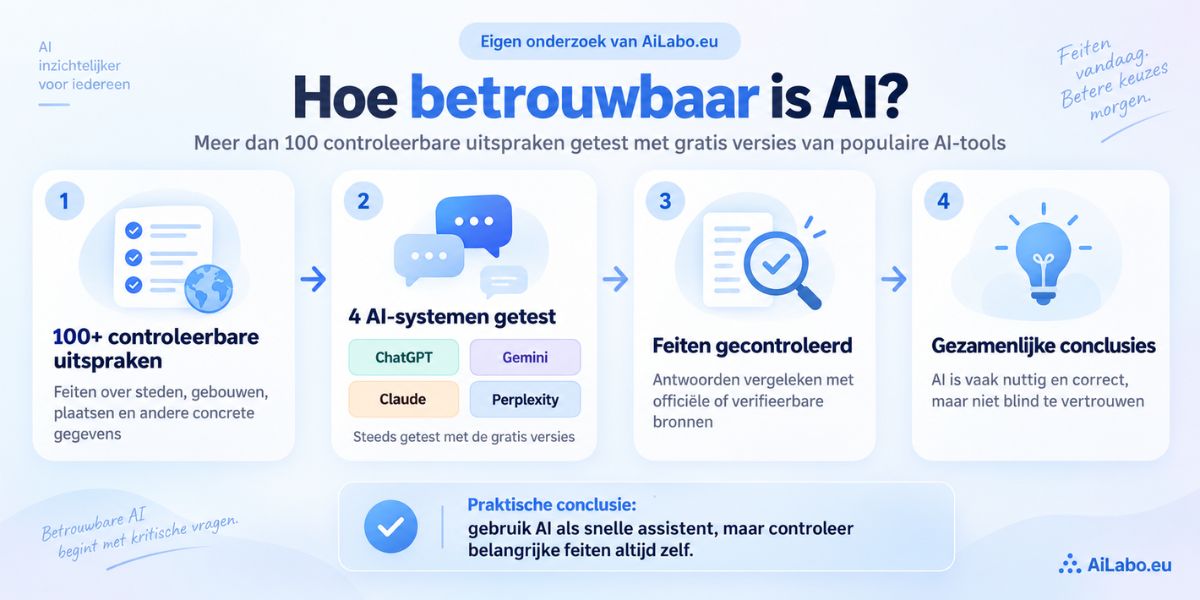
We leggen populaire taalmodellen concrete uitspraken voor over steden, gebouwen, personen, plaatsen en andere onderwerpen. Geen vragen over smaak, schrijfstijl of interpretatie, maar informatie waarbij uiteindelijk kan worden vastgesteld of het antwoord juist of fout is.
Inmiddels hebben we in verschillende praktijktests meer dan honderd controleerbare uitspraken naast de antwoorden van verschillende AI-systemen gelegd en de feiten afzonderlijk gecontroleerd.
De belangrijkste conclusie is duidelijk: ook bij informatie die objectief verifieerbaar is, kun je AI niet blind vertrouwen. De modellen geven heel vaak correcte informatie, maar maken ook fouten bij feiten waarover eigenlijk geen discussie mogelijk is.
Op deze pagina brengen we de resultaten van al die tests samen. We zoeken naar terugkerende patronen, bekijken verschillen tussen de AI-systemen en leggen vooral uit wat je daar als gewone gebruiker praktisch uit kunt leren.
Op deze pagina
Wat leerden onze tests over de betrouwbaarheid van AI?
- Waarom Feit of Fictie een interessante AI-test is
- Hoe testen we de betrouwbaarheid van AI?
- Zo controleren we de antwoorden van AI
- Waarom testen we de gratis versies?
- Wat leren 120 gecontroleerde stellingen?
- De resultaten in cijfers: welk AI-model eindigt het vaakst bovenaan?
- Waar gaat AI nog de fout in?
- Welk AI-model scoort het best in onze Feit of Fictie-tests?
- Wat betekent dit voor jou als AI-gebruiker?
- Hoe controleer je zelf een antwoord van AI?
- Bekijk onze Feit of Fictie-tests
- Wat zijn de beperkingen van dit onderzoek?
Het uitgangspunt
Waarom Feit of Fictie een interessante test is voor de betrouwbaarheid van AI
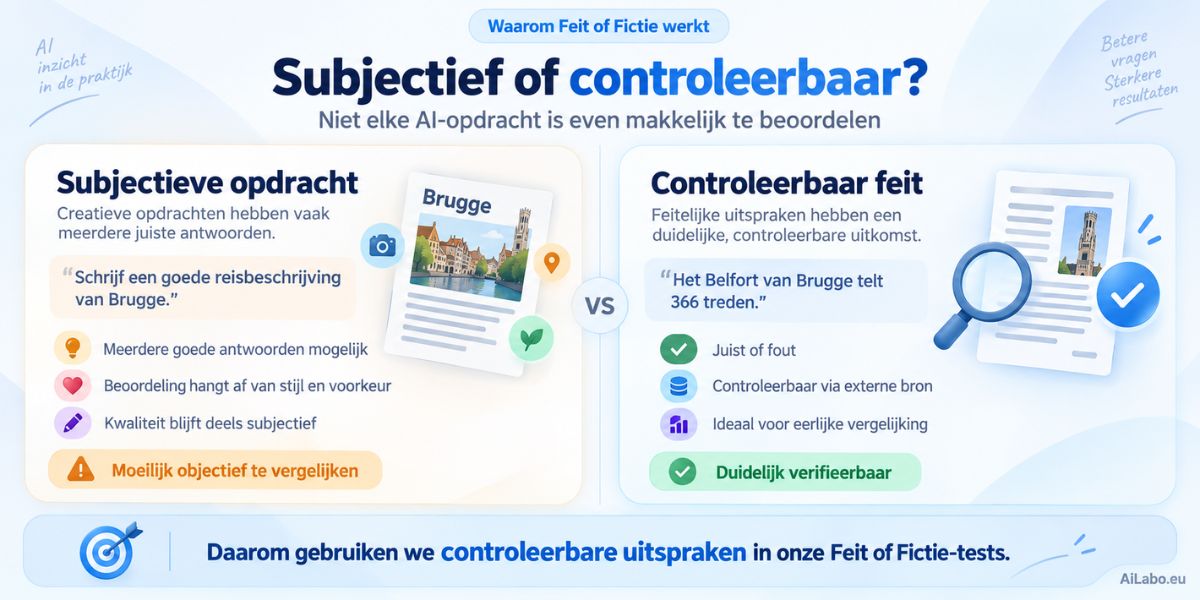
De vraag “Hoe betrouwbaar is AI?” lijkt eenvoudig, maar is verrassend moeilijk te testen. Veel opdrachten aan een taalmodel hebben namelijk geen duidelijk juist of fout antwoord.
Laat je drie AI-systemen bijvoorbeeld een e-mail schrijven, een tekst samenvatten of een reis voorstellen, dan kun je de resultaten vergelijken. Maar een deel van de beoordeling blijft subjectief. De ene persoon vindt een tekst duidelijker, de andere aantrekkelijker. Ook over volledigheid, stijl of relevantie kan discussie ontstaan.
Bij onze Feit of Fictie-tests proberen we dat probleem zoveel mogelijk weg te nemen. We kiezen uitspraken waarvan de kern controleerbaar is aan de hand van externe bronnen.
Een voorbeeld: over de vraag of een beschrijving van het Belfort van Brugge mooi of volledig is, kun je discussiëren. Over een concreet gegeven zoals het aantal treden naar de top kan uiteindelijk worden gecontroleerd of het genoemde cijfer klopt.
Precies daarom zijn deze tests voor ons interessant. Wanneer een taalmodel een controleerbaar feit verkeerd beoordeelt, hoeven we niet te discussiëren over schrijfstijl of persoonlijke voorkeur. We kunnen het antwoord naast de beschikbare informatie leggen en controleren.
Feit of Fictie is daardoor niet alleen een quiz. Het is voor AiLabo.eu een eenvoudige maar consequente manier geworden om in de praktijk te onderzoeken hoe betrouwbaar AI omgaat met feitelijke informatie.
Onze werkwijze
Hoe testen we de betrouwbaarheid van AI?
Voor de Feit of Fictie-reeks gebruiken we geen speciaal laboratorium en proberen we ook geen academische benchmark na te bootsen. We testen de AI-systemen zoals een gewone gebruiker ze in de praktijk zou kunnen gebruiken.
Eén afzonderlijke test zegt natuurlijk weinig. Een model kan toevallig vijf moeilijke vragen correct beantwoorden en de volgende dag een eenvoudig feit verkeerd hebben. Daarom is voor deze overzichtspagina vooral de combinatie van verschillende tests interessant.
Door meer dan honderd uitspraken naast elkaar te leggen, kunnen we voorzichtig kijken naar patronen. Niet om één model definitief tot winnaar uit te roepen, maar om te zien welke lessen voor praktisch AI-gebruik regelmatig terugkomen.
Van AI-antwoord naar controleerbaar feit
Zo controleren we de antwoorden van AI
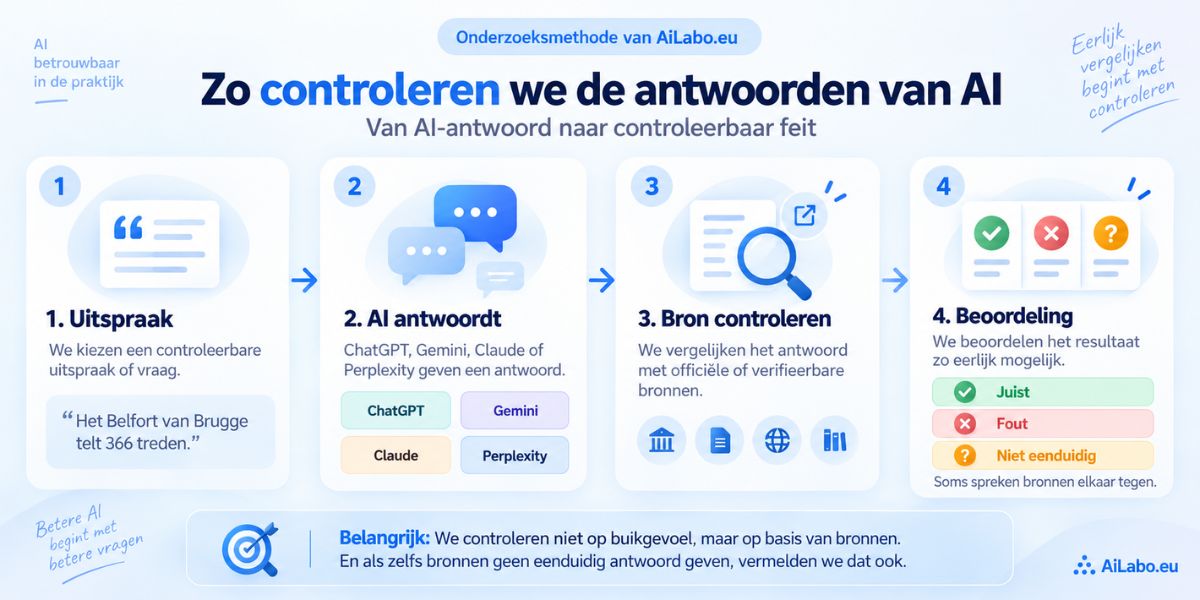
Een antwoord van een taalmodel beoordelen we niet op buikgevoel. Waar mogelijk zoeken we naar een primaire of officiële bron waarmee de uitspraak onafhankelijk kan worden gecontroleerd.
Onderstaande voorbeelden uit onze test over Brugge tonen hoe dat in de praktijk werkt.
1. Hoeveel treden telt het Belfort van Brugge?
Dit is een goed voorbeeld van een feit waarover weinig ruimte voor interpretatie bestaat. Het officiële toeristische platform van Brugge vermeldt dat bezoekers 366 treden beklimmen om de top van het Belfort te bereiken.
2. Kregen de Brugse UNESCO-sites allemaal in hetzelfde jaar erkenning?
Nee. Ook dat kunnen we precies controleren. Het Brugse Begijnhof werd in 1998 erkend, het Belfort volgde in 1999 en het historische stadscentrum in 2000.
Dit soort uitspraken is bijzonder interessant voor onze Feit of Fictie-tests: een antwoord kan heel aannemelijk klinken, terwijl één verkeerd jaartal voldoende is om de uitspraak fout te maken.
3. Wat als officiële bronnen elkaar tegenspreken?
Onze controle levert niet altijd een eenvoudige uitslag op. Dat merkten we bij een vraag over het aantal plaatsen in de plenaire zaal van het Bruges Meeting & Convention Centre.
De eigen website van het BMCC vermeldt voor de plenaire zaal een maximale capaciteit van 516 deelnemers. In officiële documenten van Stad Brugge komen echter andere capaciteitscijfers voor.
In zo’n geval vinden we het niet correct om een AI-antwoord zomaar als juist of fout af te vinken. De tegenstrijdigheid tussen de bronnen wordt dan zelf onderdeel van de analyse.
Bron 1: BMCC – Plenary room
Waarom dit belangrijk is: onze tests gaan niet alleen na wat een AI-systeem antwoordt. We proberen ook zelf vast te stellen wat het correcte antwoord is. En wanneer zelfs betrouwbare bronnen geen eenduidig antwoord geven, vermelden we die onzekerheid in plaats van een kunstmatige zekerheid te creëren.
Een bewuste keuze
Waarom testen we gratis versies van ChatGPT, Gemini, Claude en Perplexity?
Bij deze tests kiezen we bewust voor de gratis beschikbare versies van de populaire AI-systemen. Ons doel is namelijk niet om te bepalen wat een taalmodel onder ideale technische omstandigheden maximaal kan presteren.
We willen vooral weten wat iemand kan verwachten wanneer hij of zij een populaire AI-assistent opent en zonder gespecialiseerd abonnement een gewone vraag stelt. Dat sluit beter aan bij de praktische insteek van AiLabo.eu.
De vraag die ons interesseert is dus niet:
“Wat is theoretisch het beste taalmodel?”
Maar eerder:
“Hoe betrouwbaar is de AI die een gewone gebruiker vandaag daadwerkelijk kan gebruiken?”
Dat betekent ook dat onze resultaten niet automatisch hetzelfde zijn als benchmarks van betalende topmodellen. Een betaald abonnement kan toegang geven tot andere of krachtigere modellen, extra functies of ruimere gebruikslimieten.
Bovendien veranderen AI-diensten voortdurend. Modellen worden vernieuwd en aanbieders kunnen aanpassen welk model achter een gratis versie zit. Daarom beschouwen we individuele tests altijd als een momentopname. Voor deze overzichtspagina zijn vooral patronen die in meerdere tests terugkomen interessant.
Meer dan honderd controles
Hoe betrouwbaar is AI? Dit leren onze tests tot nu toe
Wanneer we alle Feit of Fictie-tests samen bekijken, valt eerst iets positiefs op: de taalmodellen weten veel. Een groot deel van de uitspraken wordt correct beoordeeld, ook wanneer het om vrij specifieke lokale informatie gaat.
Maar juist daardoor ontstaat een belangrijk risico. Wanneer een AI-systeem negen feiten correct geeft, is het verleidelijk om ook het tiende antwoord zonder controle te geloven.
Onze belangrijkste conclusie: AI kan zeer nuttig en vaak correct zijn, maar “meestal juist” is niet hetzelfde als “betrouwbaar genoeg om nooit te controleren”.
In onze tests zien we dat taalmodellen ook fouten kunnen maken bij informatie die op zichzelf perfect controleerbaar is. Dat gaat niet alleen om ingewikkelde redeneringen of controversiële onderwerpen. Ook concrete namen, aantallen, locaties, historische gegevens en lokale feiten kunnen verkeerd worden beoordeeld.
Wie wil weten hoe betrouwbaar AI is, moet daarom niet alleen kijken naar hoe overtuigend een antwoord klinkt. De belangrijkste vraag blijft of de informatie waarop je wilt vertrouwen ook onafhankelijk kan worden gecontroleerd.
Het grootste risico
Waar gaat AI nog de fout in?
Een fout antwoord van een taalmodel ziet er meestal niet uit als een fout antwoord. Dat is misschien wel de belangrijkste praktische les uit onze tests.
AI kan een fout feit formuleren in dezelfde rustige en overtuigende stijl als een correct feit. Er verschijnt geen rood waarschuwingslampje en het model schrijft niet noodzakelijk: “Ik ben hier eigenlijk niet zeker van.”
Een antwoord kan zeer precies zijn, een concreet cijfer bevatten en volledig zelfverzekerd geformuleerd worden, terwijl het onderliggende feit toch niet klopt.
Onze Feit of Fictie-tests maken dat probleem bijzonder zichtbaar. Omdat we de uitspraken achteraf controleren, kunnen we het verschil zien tussen een overtuigend antwoord en een correct antwoord.
Wil je beter begrijpen waarom dit gebeurt? Lees dan ook: Kan AI fouten maken?
Dat betekent niet dat je ieder woord van een AI-assistent voortdurend moet wantrouwen. Het betekent wel dat het belang van de informatie moet bepalen hoeveel controle nodig is.
De modellen naast elkaar
Welk AI-model scoort het best in onze Feit of Fictie-tests?
Na 12 tests is de tendens duidelijk. ChatGPT eindigde in 10 van de 12 tests op of gedeeld op de eerste plaats. Acht keer was ChatGPT alleen winnaar en twee keer deelde het model de eerste plaats.
Claude eindigde vier keer bovenaan: twee keer als enige winnaar en twee keer gedeeld. Gemini en Perplexity haalden elk één gedeelde overwinning.
Die cijfers zeggen niet dat één model altijd beter is dan de rest. De resultaten verschillen per test, en soms scoren meerdere modellen perfect.
In onze test over Mechelen beoordeelden ChatGPT, Gemini, Claude en Perplexity alle tien de stellingen correct. De vier modellen delen daar dus de eerste plaats.
Ook in onze test over Roeselare was er een gedeelde overwinning: ChatGPT en Claude hadden alle tien de eindoordelen correct.
Maar ieder model kan ook de mist ingaan
In onze test over Hasselt beweerde Gemini dat presentator en schrijver Jos Ghysen niet in Hasselt, maar in Luik werd geboren. Een concreet biografisch feit waarbij uiteindelijk maar één correct antwoord mogelijk is.
In onze test over Antwerpen kregen de modellen de stelling voorgelegd dat het Plantin-Moretusmuseum het eerste museum ter wereld was dat op de UNESCO-Werelderfgoedlijst werd opgenomen. De stelling is juist, maar Perplexity beoordeelde ze als fout.
In onze test over Oostende kreeg ChatGPT de stelling dat Marvin Gaye een tijd in Oostende verbleef en dat de videoclip van Sexual Healing werd opgenomen in het Casino-Kursaal. De stelling is juist, maar ChatGPT koos voor “onvoldoende bewijs”.
Claude presteert in deze reeks sterk en eindigde vier keer bovenaan. Het verschil met ChatGPT zit niet alleen in het juiste of foute eindoordeel. Claude grijpt bij de onderbouwing vaker terug naar Wikipedia, terwijl ChatGPT in onze tests vaker rechtstreeks naar officiële of primaire bronnen verwijst. Voor het controleren van concrete feiten geven wij aan die laatste aanpak de voorkeur.
De voorbeelden tonen dat “fout” verschillende vormen kan aannemen: een model kan een verkeerd feit geven, een juiste stelling afwijzen, te weinig bewijs zien of minder sterke bronnen kiezen voor zijn onderbouwing.
Onze conclusie na 12 tests: ChatGPT presteerde binnen deze reeks het meest consistent en eindigde 10 keer op of gedeeld op de eerste plaats. Claude volgt met vier eerste plaatsen, waarvan twee gedeeld. De foutloze resultaten in Mechelen en Roeselare tonen tegelijk dat de verschillen per test aanzienlijk kunnen zijn. Geen enkel model is altijd de beste — en geen enkel model is foutloos.
De resultaten in cijfers
12 tests, 120 stellingen: welk AI-model eindigt het vaakst bovenaan?
De Feit of Fictie-reeks omvat momenteel 12 afzonderlijke tests met telkens 10 controleerbare stellingen. Iedere test werd voorgelegd aan ChatGPT, Gemini, Claude en Perplexity. Samen levert dat een onderzoeksopzet op van 120 stellingen en 480 afzonderlijke modelbeoordelingen.
Hoe vaak eindigde elk model als winnaar?
| AI-model | Alleen winnaar | Gedeeld winnaar | Totaal bovenaan |
|---|---|---|---|
| ChatGPT | 8 | 2 | 10 van 12 |
| Claude | 2 | 2 | 4 van 12 |
| Gemini | 0 | 1 | 1 van 12 |
| Perplexity | 0 | 1 | 1 van 12 |
In onze test over Mechelen beoordeelden ChatGPT, Gemini, Claude en Perplexity alle tien de stellingen correct. De vier modellen eindigden er dus samen op de eerste plaats.
Ook in onze test over Roeselare was er geen enkele winnaar: ChatGPT en Claude beoordeelden alle tien de stellingen correct en delen daar de eerste plaats.
De duidelijkste conclusie uit de cijfers: ChatGPT eindigde in 10 van de 12 tests op of gedeeld op de eerste plaats. Acht keer was ChatGPT alleen winnaar en twee keer deelde het model de eerste plaats.
Claude eindigde vier keer bovenaan: twee keer alleen en twee keer gedeeld. Gemini en Perplexity haalden elk één gedeelde overwinning, in Mechelen.
Binnen deze 12 tests, deze 120 stellingen en de gebruikte gratis versies komt ChatGPT dus als het meest consistente model naar voren. Claude volgt op enige afstand, maar toont met onder meer het foutloze resultaat in Roeselare dat het eveneens zeer sterk kan presteren.
Voor dagelijks gebruik
Wat betekent dit voor jou als AI-gebruiker?
Onze conclusie is niet dat je ChatGPT, Gemini, Claude of Perplexity beter niet gebruikt. Integendeel. Juist omdat deze systemen zoveel informatie snel kunnen verwerken, zijn ze bijzonder nuttig.
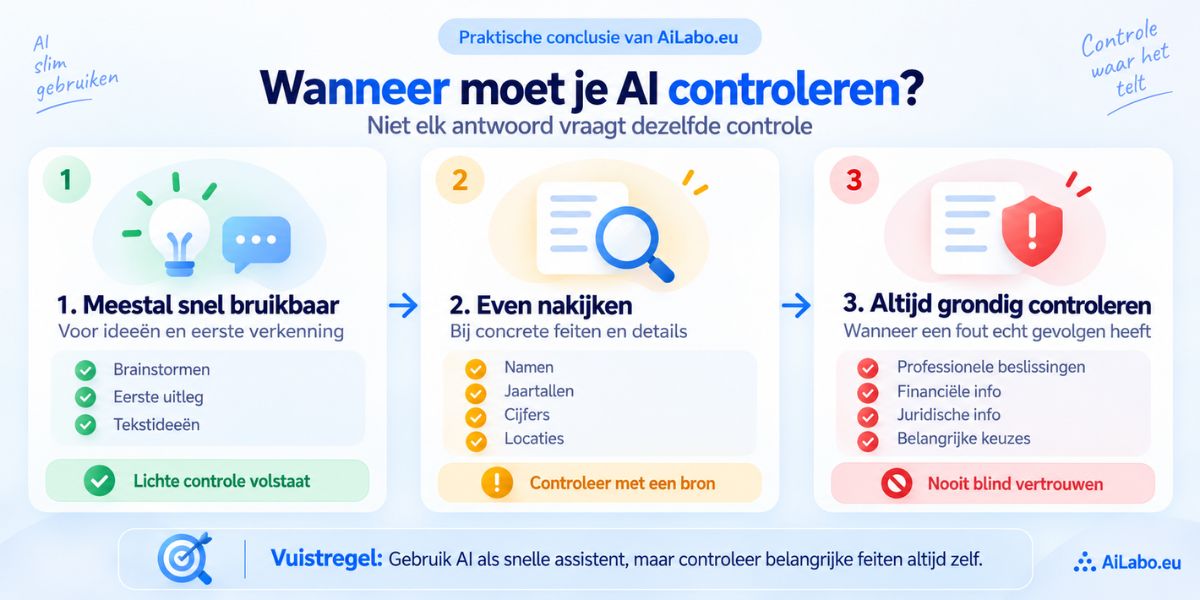
De kunst bestaat erin te weten wanneer een antwoord goed genoeg is en wanneer je moet controleren.
Een taalmodel kun je daarom het best zien als een zeer snelle assistent: bijzonder handig om mee te werken, maar niet automatisch de eindverantwoordelijke voor de feiten.
Praktische tip
Hoe controleer je zelf of een antwoord van AI betrouwbaar is?
Je hoeft niet ieder antwoord uitgebreid te factchecken. Bij belangrijke feitelijke informatie kun je met een paar eenvoudige stappen het risico op fouten wel aanzienlijk verkleinen.
-
Herken welke informatie controleerbaar is.
Let vooral op concrete cijfers, data, namen, wetten, locaties, producteigenschappen, historische feiten en andere specifieke beweringen. -
Vraag de AI waarop het antwoord gebaseerd is.
Dat garandeert nog niet dat het antwoord correct is, maar kan wel helpen om te bepalen waar je verder moet zoeken. -
Ga indien mogelijk naar de oorspronkelijke bron.
Een officiële website, organisatie, handleiding of andere primaire bron is meestal waardevoller dan een tweede samenvatting van hetzelfde feit. -
Controleer belangrijke informatie bij een tweede bron.
Zeker wanneer een fout financiële, professionele of andere belangrijke gevolgen kan hebben. -
Laat een zelfverzekerde schrijfstijl je niet misleiden.
Onze tests tonen juist dat een fout antwoord even overtuigend kan klinken als een correct antwoord.
Bekijk het bronmateriaal
Bekijk onze individuele Feit of Fictie-tests
De conclusies op deze pagina zijn niet gebaseerd op één quiz of een handvol losse vragen. Ze komen voort uit een groeiende reeks afzonderlijke praktijktests.
Wie zelf wil bekijken welke uitspraken werden getest, hoe de AI-systemen antwoordden en hoe we tot onze conclusies kwamen, kan de afzonderlijke tests raadplegen.
Deze reeks wordt verder aangevuld. Nieuwe Feit of Fictie-tests kunnen ook worden meegenomen in de conclusies op deze overzichtspagina.
Transparantie
Dit is praktijkonderzoek, geen wetenschappelijke benchmark
Hoewel we inmiddels meer dan honderd uitspraken hebben gecontroleerd, willen we de resultaten niet groter voorstellen dan ze zijn.
Dit is geen wetenschappelijke studie en ook geen gestandaardiseerde technische benchmark waarmee definitief kan worden bepaald welk taalmodel het beste is.
De onderwerpen in onze Feit of Fictie-reeks zijn bewust gekozen vanuit praktisch gebruik en bevatten onder andere veel lokale en concrete kennis. Een ander soort vragenverzameling kan andere resultaten opleveren.
Daarnaast ontwikkelen AI-systemen zich zeer snel. Een antwoord dat een model vandaag geeft, kan na een update anders zijn. Ook de modellen die beschikbaar zijn binnen gratis abonnementen kunnen in de loop van de tijd veranderen.
De waarde van deze reeks zit daarom vooral in de combinatie van veel afzonderlijke, controleerbare praktijkvoorbeelden. Naarmate er nieuwe tests bijkomen, kunnen we bekijken of de patronen die we vandaag zien bevestigd worden of juist veranderen.
Onze conclusie
Dus: hoe betrouwbaar is AI?
Betrouwbaar genoeg om bijzonder nuttig te zijn, maar niet betrouwbaar genoeg om belangrijke feiten altijd zonder controle over te nemen.
Dat is de rode draad die we terugzien wanneer we de resultaten van onze Feit of Fictie-tests samen bekijken.
ChatGPT, Gemini, Claude en Perplexity kunnen indrukwekkend veel correcte informatie geven. Tegelijk tonen onze tests dat ieder systeem ook fouten kan maken bij zaken die objectief controleerbaar zijn.
Gebruik AI daarom vooral waarvoor het bijzonder goed is: snel informatie verwerken, mogelijkheden verkennen, ideeën ontwikkelen en je helpen bij taken. Maar wanneer een concreet feit ertoe doet, blijft één eenvoudige gewoonte verstandig: controleer het.
Over de auteur
Peter Van Genabet
Oprichter van AiLabo.eu. Ik schrijf over praktische toepassingen van AI en onderzoek hoe gewone gebruikers betere en betrouwbaardere resultaten uit AI-tools kunnen halen. Lees meer over mijn achtergrond en de aanpak achter AiLabo.eu .
Bekijk ook mijn LinkedIn-profiel .