Wie bewerkt een bestaande foto het best: ChatGPT, Gemini of Perplexity?
AI kan tegenwoordig niet alleen afbeeldingen maken, maar ook bestaande foto’s aanpassen. Maar hoe nauwkeurig gebeurt dat wanneer je verschillende wijzigingen tegelijk vraagt?
Voor deze praktijktest gaf ik ChatGPT, Gemini en Perplexity exact dezelfde foto en dezelfde opdracht. De drie modellen moesten een trui van kleur veranderen, een klok op een exact tijdstip zetten en tekst toevoegen aan een koffiemok. Tegelijk mochten ze niets anders aan de afbeelding veranderen.
Dezelfde afbeelding, dezelfde prompt
Om de vergelijking zo eerlijk mogelijk te maken, uploadde ik bij elk model dezelfde originele afbeelding. Daarna gaf ik ChatGPT, Gemini en Perplexity exact dezelfde instructie.
Ik beoordeelde vervolgens of de drie gevraagde aanpassingen correct waren uitgevoerd en in welke mate de rest van de oorspronkelijke foto behouden bleef.
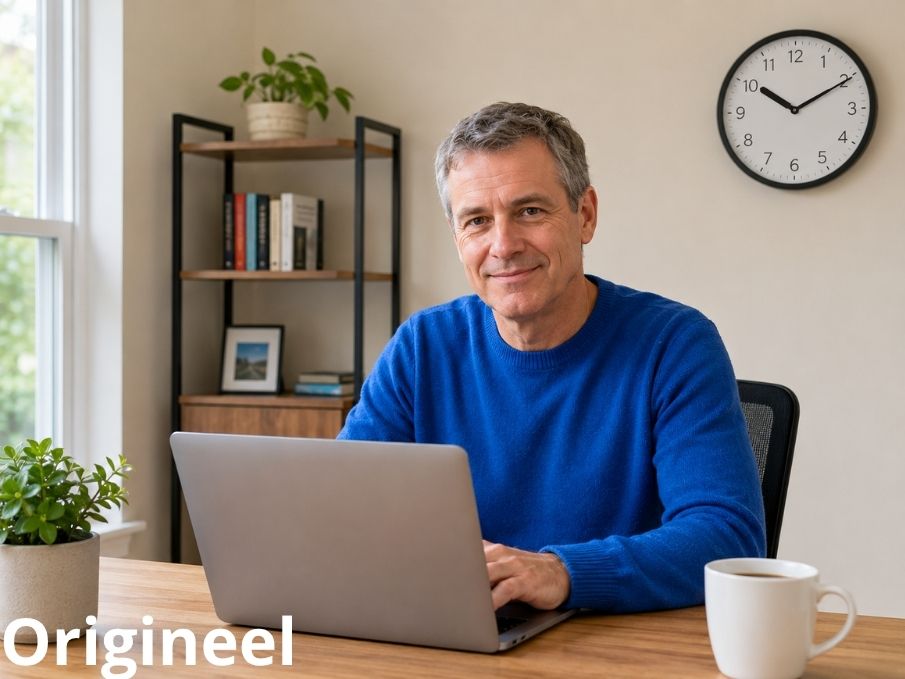
Dit was de originele afbeelding
Hieronder zie je de originele foto die ik daadwerkelijk bij alle drie de modellen heb geüpload. De blauwe trui, de klok aan de muur en de witte koffiemok zijn bewust duidelijk zichtbaar, zodat je de drie resultaten verderop op deze pagina zelf met het origineel kunt vergelijken.
Exact dezelfde prompt voor de drie modellen
Bewerk deze afbeelding en voer exact de volgende drie wijzigingen uit:
- Verander de trui van de persoon van blauw naar groen.
- Zet de klok aan de muur op kwart voor 4.
- Plaats op de witte koffiemok het woord “Koffie” in duidelijk leesbare letters.
Voer geen enkele andere wijziging uit.
Behoud exact dezelfde persoon, hetzelfde gezicht, dezelfde pose, dezelfde achtergrond,
dezelfde plant, dezelfde laptop, hetzelfde bureau, dezelfde stoel, hetzelfde boekenrek
en dezelfde algemene beeldcompositie. De afbeelding moet verder ongewijzigd blijven.
Over deze praktijktest
De vier foto’s van de test die je ziet zijn de beelden die daadwerkelijk voor deze vergelijking zijn gebruikt: de originele bronafbeelding en de resultaten die ik kreeg van ChatGPT, Gemini en Perplexity. De resultaten zijn dus niet achteraf opnieuw gemaakt of vervangen voor publicatie.
Voor publicatie op AiLabo.eu heb ik de resolutie van de foto’s bewust verlaagd, zodat deze pagina sneller laadt. De afbeeldingen op deze webpagina zijn daarom niet geschikt om verschillen in oorspronkelijke bestandsgrootte of technische resolutie te beoordelen. In deze test beoordelen we hoe correct de modellen de gevraagde beeldbewerking hebben uitgevoerd.
ChatGPT
Hieronder zie je het daadwerkelijke beeld dat ChatGPT tijdens deze test opleverde.
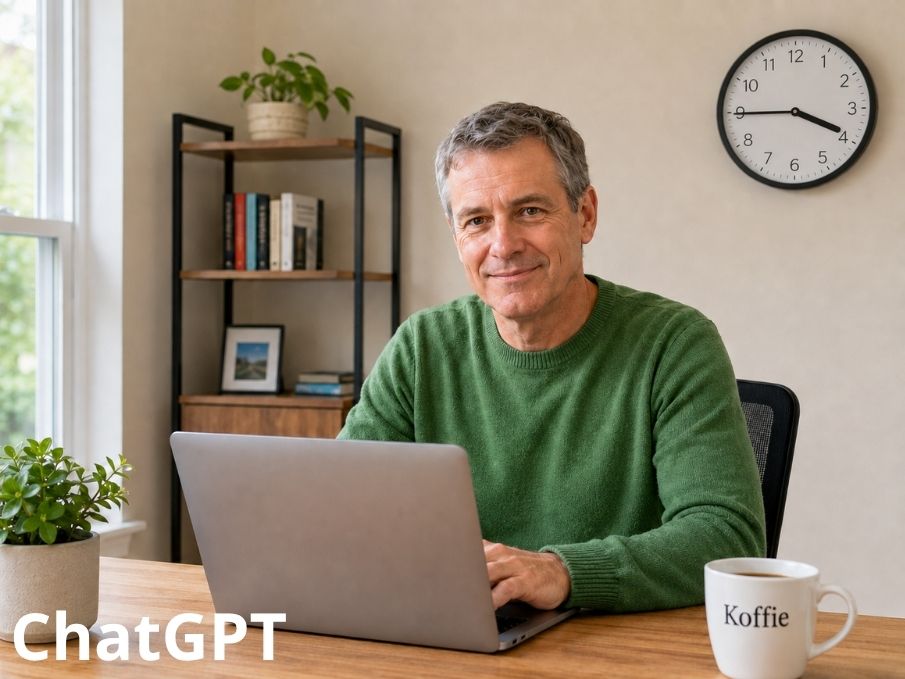
Zoals je op het testbeeld hierboven kunt zien, voert ChatGPT de drie gevraagde wijzigingen zeer goed uit. De blauwe trui is groen geworden, de klok staat correct op 3u45 en het woord “Koffie” staat duidelijk en correct op de witte mok.
Ook de persoon, pose, achtergrond en algemene compositie blijven zeer goed behouden.
Gemini
Hieronder staat het daadwerkelijke resultaat dat Gemini tijdens dezelfde test genereerde.
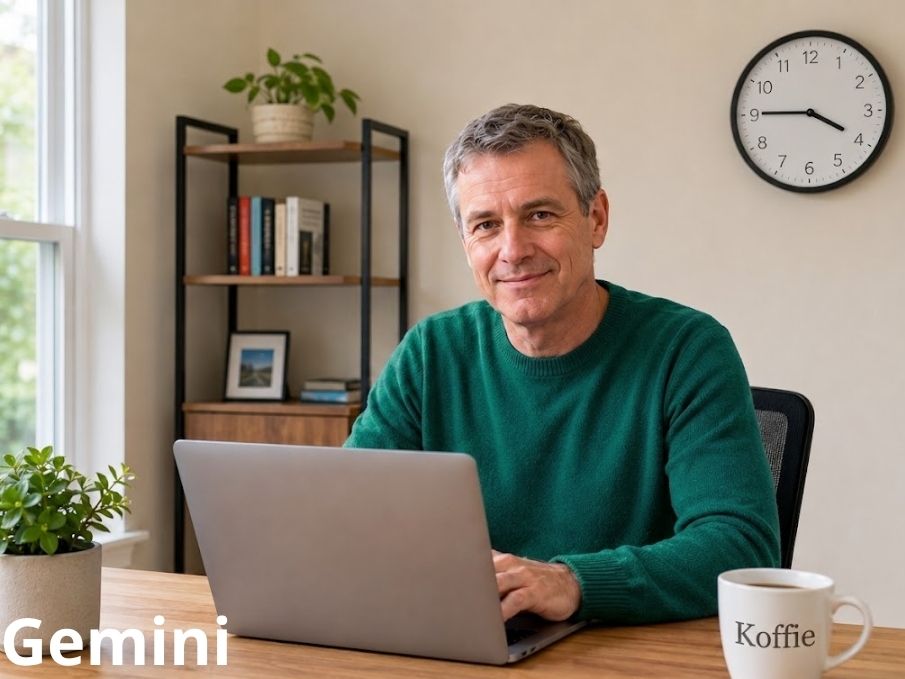
Ook op het resultaat van Gemini hierboven zijn de drie gevraagde wijzigingen correct uitgevoerd. De trui is groen, de klok staat op 3u45 en “Koffie” staat duidelijk en correct op de mok.
De persoon en de belangrijkste onderdelen van het originele beeld blijven eveneens goed behouden. Daarmee presteert Gemini in deze test op hetzelfde hoge niveau als ChatGPT.
Perplexity
Hieronder zie je het daadwerkelijke resultaat van Perplexity bij dezelfde bronfoto en dezelfde prompt.
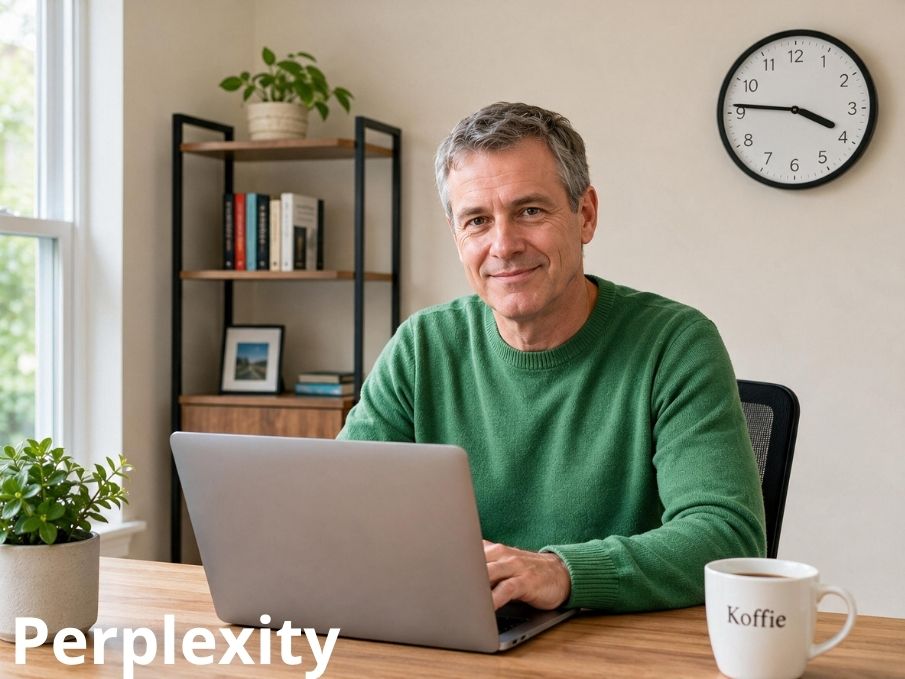
Ook Perplexity voert het grootste deel van de opdracht goed uit. De trui is groen geworden en het woord “Koffie” staat correct en duidelijk leesbaar op de mok.
Op de hierboven getoonde afbeelding is echter ook een kleine maar controleerbare afwijking zichtbaar. Gevraagd werd kwart voor vier, dus exact 3u45, terwijl de klok in het resultaat van Perplexity ongeveer 3u46 aangeeft.
ChatGPT en Gemini delen de eerste plaats
| Model | Resultaat | Score |
|---|---|---|
| ChatGPT | Alle drie de opdrachten zeer goed uitgevoerd | 9,5/10 |
| Gemini | Alle drie de opdrachten zeer goed uitgevoerd | 9,5/10 |
| Perplexity | Sterk resultaat, maar klok staat ongeveer op 3u46 | 8,5/10 |
Eenvoudige beeldbewerking lukt ondertussen verrassend goed
De vier afbeeldingen op deze pagina maken het resultaat goed controleerbaar: je kunt de originele foto zelf vergelijken met wat ChatGPT, Gemini en Perplexity ervan maakten.
ChatGPT en Gemini eindigen gedeeld op de eerste plaats met 9,5/10. Beide modellen voeren de drie opdrachten zeer overtuigend uit. Perplexity scoort met 8,5/10 eveneens sterk, maar verliest punten doordat de klok ongeveer 3u46 aangeeft in plaats van exact 3u45.
De verschillen zijn klein. Dat is op zichzelf misschien wel de interessantste conclusie: voor dit soort relatief eenvoudige fotobewerking zijn alle drie de modellen inmiddels praktisch bruikbaar. In volgende tests maken we de opdrachten daarom stap voor stap moeilijker.