AI-test • Afbeeldingen vergelijken • Visuele herkenning
Hoe goed vindt AI de verschillen tussen twee foto’s? Vier modellen getest
Ken je die puzzels waarbij je twee bijna identieke afbeeldingen krijgt en alle verschillen moet zoeken? Voor mensen kan dat behoorlijk lastig zijn. Maar hoe goed zijn AI-modellen in zo’n opdracht?
ChatGPT, Gemini, Claude en Perplexity kunnen afbeeldingen analyseren. Je kunt ze vragen wat er op een foto staat, bepaalde voorwerpen te herkennen of twee afbeeldingen met elkaar te vergelijken.
Maar hoe nauwkeurig gebeurt die vergelijking? Zien de modellen ook kleine veranderingen? En kunnen ze onderscheid maken tussen echte verschillen en details die alleen maar anders lijken?
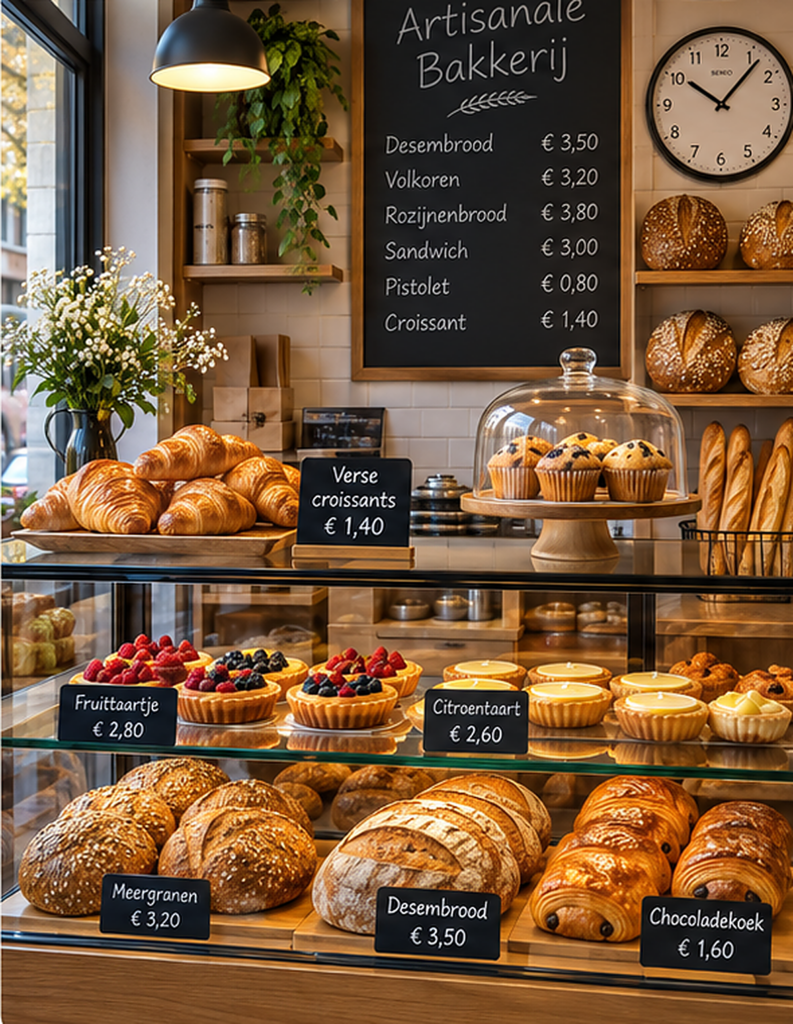
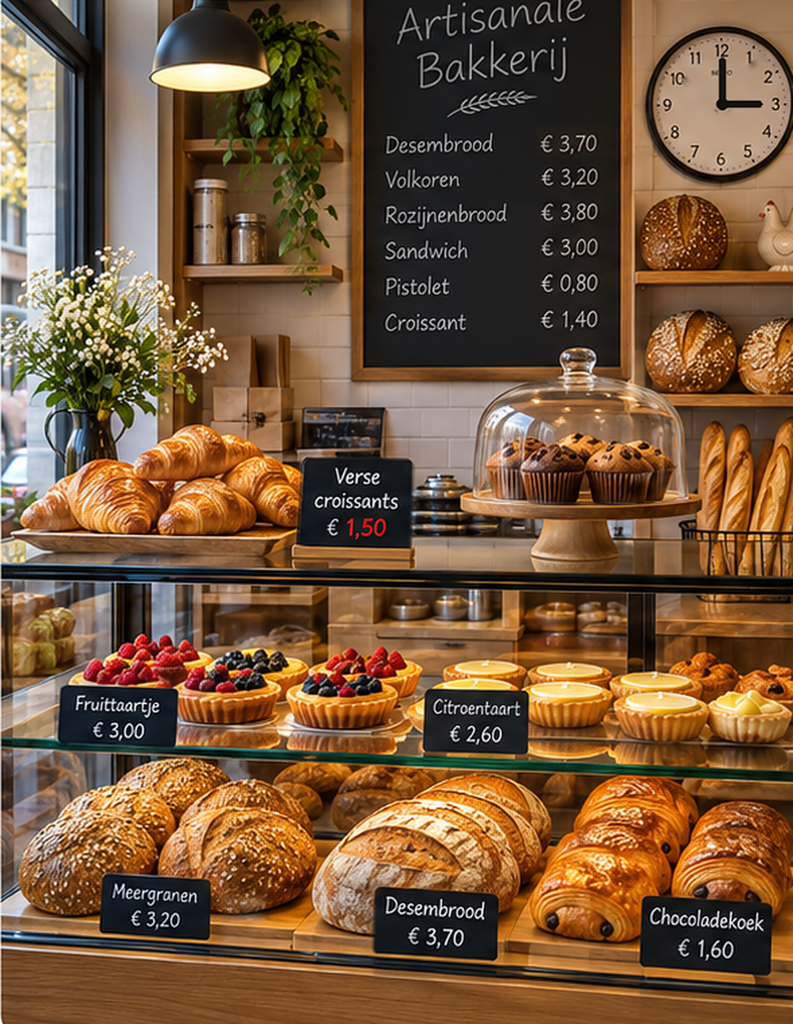
Om dat te onderzoeken, maakten we twee bijna identieke afbeeldingen van een gezellige bakkerij. In de tweede afbeelding brachten we bewust zeven verschillen aan.
Sommige verschillen zijn relatief gemakkelijk te herkennen, zoals een verandering op een prijskaartje. Andere vragen wat meer aandacht, bijvoorbeeld een gewijzigd product of een klein decoratief voorwerp.
Vervolgens gaven we de vier AI-modellen exact dezelfde opdracht. We vertelden niet hoeveel verschillen er waren en vroegen uitdrukkelijk om niets te verzinnen.
Het resultaat was bijzonder interessant. Eén model vond alle zeven verschillen, terwijl andere modellen belangrijke wijzigingen over het hoofd zagen.
In deze test bekijken we welke verschillen de AI-modellen ontdekten, welke ze misten en of ze ook afwijkingen beschreven die helemaal niet bestonden.
De test in het kort
Claude vindt alle zeven verschillen, Gemini zes
In deze AiLabo-test onderzochten we hoe goed ChatGPT, Gemini, Claude en Perplexity verschillen tussen twee afbeeldingen kunnen herkennen. We gebruikten twee vrijwel identieke foto’s van een bakkerij waarin zeven details bewust waren gewijzigd.
Claude presteerde het best en herkende alle zeven verschillen. Gemini vond zes van de zeven en miste alleen de verandering bij de muffins.
ChatGPT vond vier verschillen duidelijk en merkte een vijfde gedeeltelijk op. Perplexity identificeerde vier verschillen correct, maar miste de overige drie volledig.
Opvallend was dat ChatGPT daarnaast enkele kleine visuele afwijkingen suggereerde op plaatsen waar niets was gewijzigd. Gemini en Perplexity deden dat niet.
Dit is een kleinschalige praktijktest met één afbeeldingspaar en één antwoord per model. De resultaten zijn geen algemene rangschikking van de vier AI-assistenten.
Op deze pagina
Hoe verliep onze zoek-de-verschillen-test?
- De testopzet: twee foto’s van een bakkerij
- Bekijk zelf de twee afbeeldingen
- De exacte opdracht aan de AI-modellen
- Welke zeven verschillen hadden we aangebracht?
- ChatGPT: vier verschillen en één gedeeltelijk
- Gemini: zes van de zeven verschillen
- Claude: alle zeven verschillen gevonden
- Perplexity: vier verschillen gevonden
- De volledige vergelijking van de vier modellen
- Wat leert deze test ons over AI en beeldherkenning?
- Onze conclusie en vervolgtests
De testopzet
Twee bijna identieke bakkerijfoto’s, zeven echte verschillen
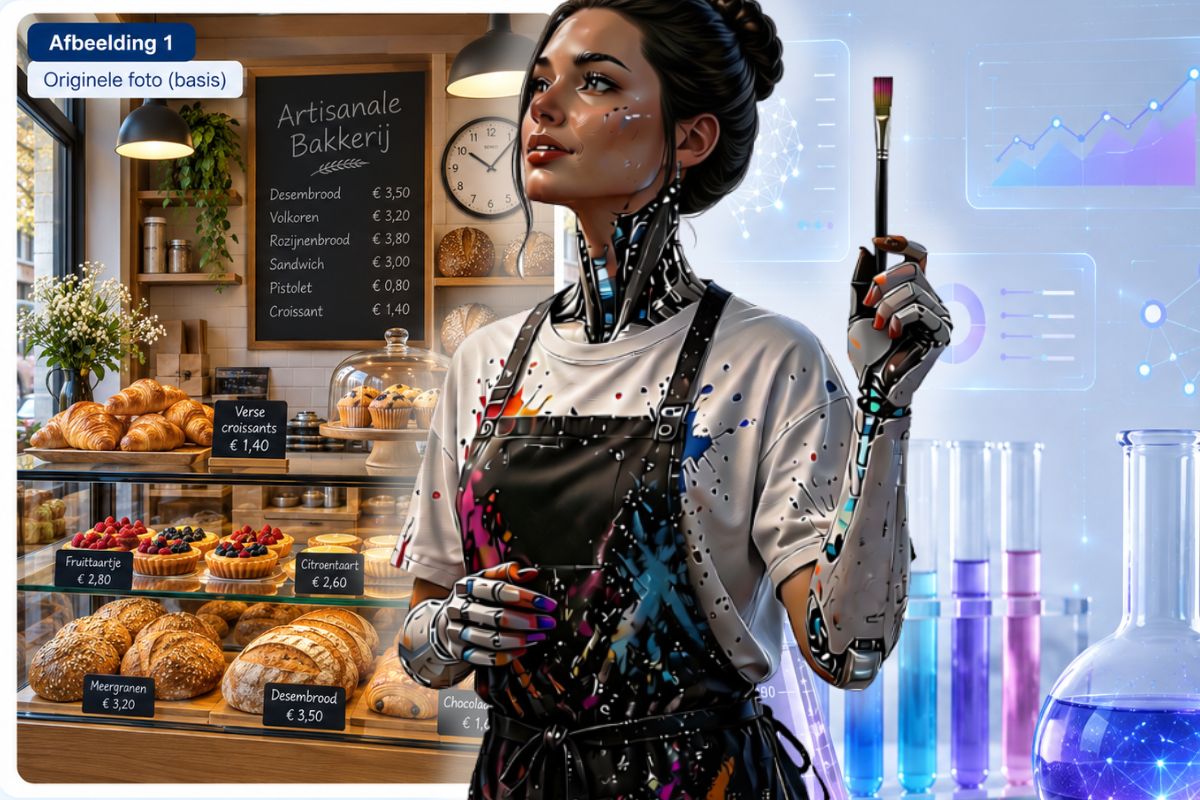
Voor deze test maakten we met AI een afbeelding van een gezellige, artisanale bakkerij. Op de foto zijn onder meer verschillende soorten brood, croissants, taartjes, muffins, prijskaartjes, wandplanken en een klok te zien.
Vervolgens maakten we een tweede versie van dezelfde afbeelding, waarin we op zeven plaatsen bewust iets veranderden.
We kozen voor een combinatie van verschillende soorten wijzigingen:
- Tekst en cijfers: kleine prijswijzigingen die je alleen ontdekt wanneer je de bordjes aandachtig bekijkt.
- Voorwerpen: een decoratieve verandering op een van de wandplanken.
- Visuele details: een gewijzigd product in de bakkerij.
- Een klok: een andere stand van de wijzers.
We zorgden ervoor dat de rest van de afbeelding identiek bleef. Zo weten we vooraf welke verschillen werkelijk bestaan en kunnen we de antwoorden objectief controleren.
Wat wilden we meten?
We keken niet alleen naar het aantal gevonden verschillen. Ook de nauwkeurigheid van de beschrijving was belangrijk.
Herkent een model bijvoorbeeld dat een prijskaartje veranderd is? Ziet het een klein decoratief voorwerp? En merkt het wanneer een gebakje door een ander soort gebakje is vervangen?
We wilden bovendien onderzoeken of de AI-modellen ook verschillen zouden vermelden die niet werkelijk aanwezig waren.
We beoordelen of een verschil correct is herkend. Welke afbeelding door het model als eerste of tweede wordt benoemd, speelt voor deze test geen rol.
Bekijk het zelf
Kun jij de zeven verschillen vinden?
Hieronder zie je de twee afbeeldingen die we aan ChatGPT, Gemini, Claude en Perplexity voorlegden.
Ze lijken op het eerste gezicht bijna identiek. Toch zijn er precies zeven bewuste verschillen aangebracht.
Misschien vind je de eerste verschillen vrij snel. Andere vallen pas op wanneer je kleine details aandachtig vergelijkt.
De opdracht
We vroegen de AI-modellen om alleen echte verschillen te benoemen
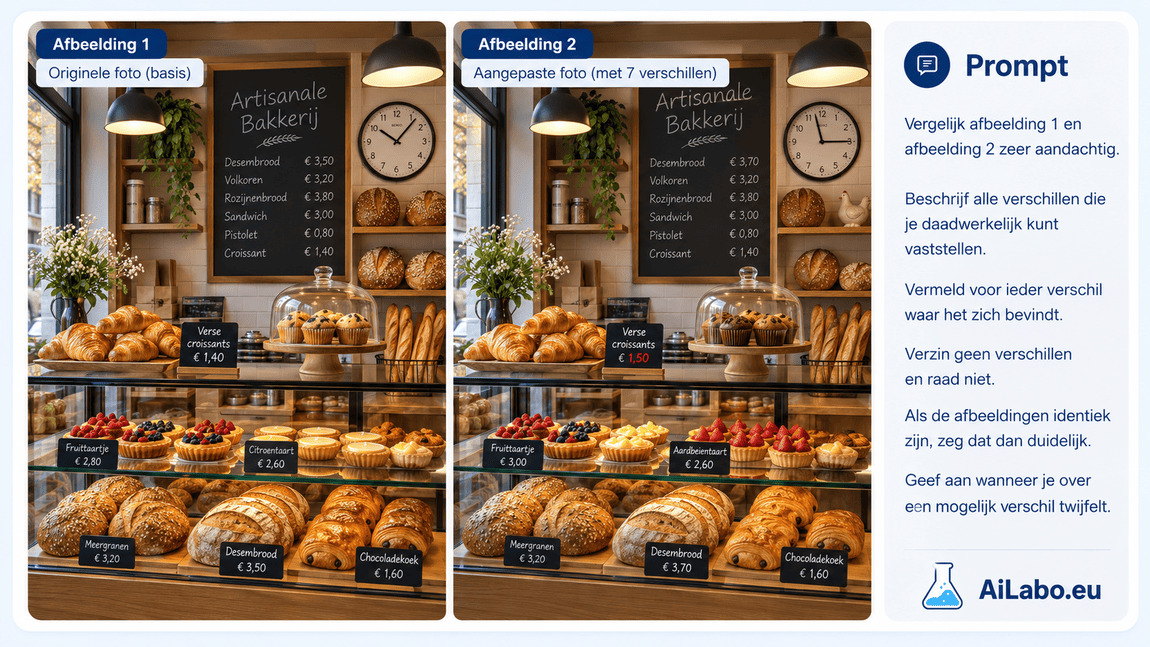
We gebruikten bewust een eenvoudige prompt. We wilden weten of de modellen zelfstandig de verschillen konden ontdekken, zonder extra aanwijzingen over de locatie of het aantal.
We vroegen ook om geen verschillen te verzinnen en twijfel duidelijk aan te geven.
Vergelijk deze twee afbeeldingen zeer aandachtig.
Beschrijf alle verschillen die je daadwerkelijk kunt vaststellen. Vermeld voor ieder verschil waar het zich bevindt.
Verzin geen verschillen en raad niet. Als de afbeeldingen identiek zijn, zeg dat dan duidelijk.
Geef aan wanneer je over een mogelijk verschil twijfelt.
Deze prompt bevat geen informatie over het aantal verschillen en vertelt de modellen ook niet waar ze moeten zoeken.
Daardoor kunnen we niet alleen beoordelen hoeveel wijzigingen ze vinden, maar ook of ze zorgvuldig met onzekerheid omgaan.
De juiste antwoorden
Dit zijn de zeven verschillen die we bewust hebben aangebracht
Om de vier AI-modellen eerlijk te kunnen beoordelen, moeten we natuurlijk precies weten wat er tussen beide afbeeldingen veranderd is.
Hieronder staan alle zeven wijzigingen. Dit vormt de basis voor onze vergelijking.
1. Prijs van desembrood op het grote krijtbord
Op het grote zwarte bord bovenaan verandert de prijs van desembrood van € 3,50 naar € 3,70.
2. De klok rechtsboven
De stand van de wijzers verandert. De klok geeft eerst ongeveer 10:10 uur aan en daarna ongeveer 3:00 uur.
3. Een wit keramieken kipje op de broodplank
Rechtsboven, bij de broden op de wandplank, verschijnt een wit decoratief kipje.
4. Prijs van de verse croissants
Op het prijskaartje bij de croissants verandert € 1,40 naar € 1,50. Ook de kleur van het prijsbedrag verandert.
5. Prijs van het fruittaartje
In de vitrine verandert het prijskaartje bij het fruittaartje van € 2,80 naar € 3,00.
6. Prijs van desembrood onderaan de vitrine
Op het afzonderlijke prijskaartje voor desembrood onderaan verandert eveneens € 3,50 naar € 3,70. Dit is een tweede, afzonderlijk aangepast prijskaartje.
7. De muffins onder de glazen stolp
De lichtere muffins met zichtbare stukjes worden vervangen door donkerdere chocolademuffins.
Sommige wijzigingen zijn gemakkelijker te ontdekken dan andere. Een prijsverschil vraagt nauwkeurig lezen, terwijl het kipje en de muffins vooral visuele herkenning vereisen.
Resultaat 1 • ChatGPT
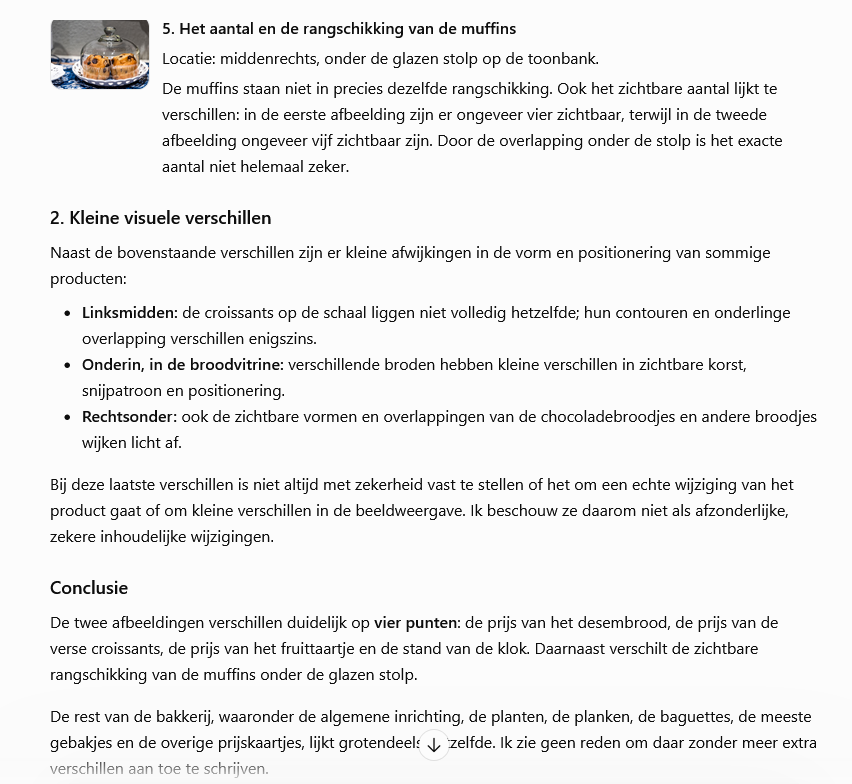
ChatGPT vindt vier verschillen duidelijk en herkent er één gedeeltelijk
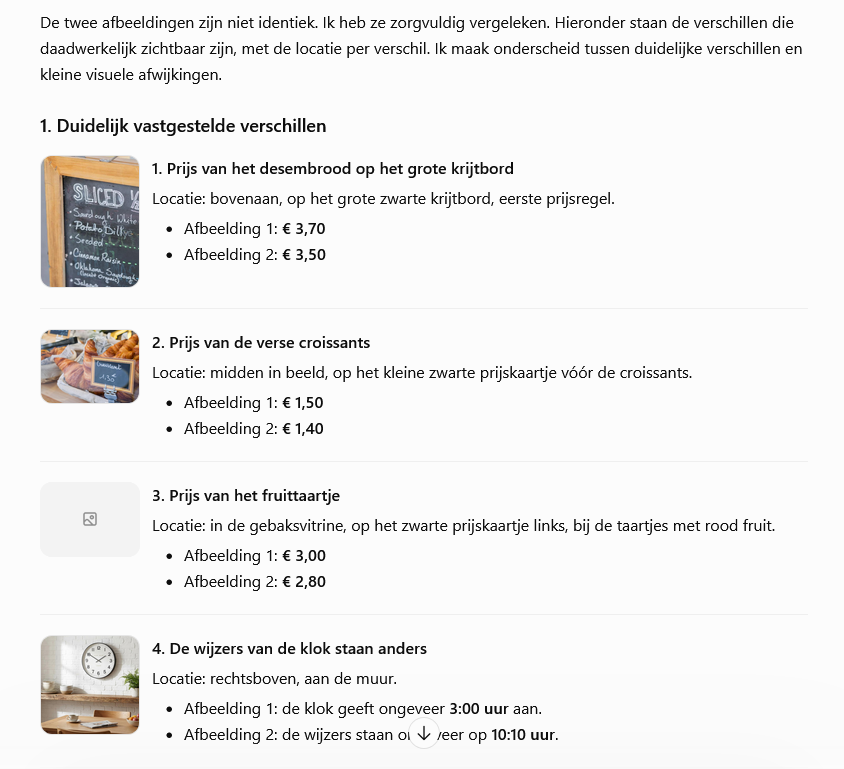
ChatGPT begon met de vaststelling dat de twee afbeeldingen niet identiek waren. Het model gaf vervolgens een overzicht van duidelijke verschillen en een afzonderlijke bespreking van kleinere, onzekere visuele afwijkingen.
Vier verschillen werden duidelijk herkend:
- De prijs van desembrood op het grote krijtbord.
- De prijs van de verse croissants.
- De prijs van het fruittaartje.
- De gewijzigde stand van de klok.
Daarnaast merkte ChatGPT op dat de muffins onder de glazen stolp er anders uitzagen. Het model sprak echter vooral over een andere rangschikking en een mogelijk verschil in aantal, zonder de vervanging door donkerdere chocolademuffins correct te identificeren.
Daarom beschouwen we dit vijfde verschil als gedeeltelijk herkend.
Opvallend: ChatGPT suggereerde ook verschillen die niet bestonden
Het model noemde daarnaast kleine afwijkingen bij de croissants, de broodkorsten en de chocoladebroodjes.
Die onderdelen waren in onze test niet gewijzigd. ChatGPT formuleerde deze observaties wel voorzichtig en gaf aan dat het niet zeker wist of het echte veranderingen waren.
Toch is dit een interessante bevinding. Zelfs wanneer je expliciet vraagt om geen verschillen te verzinnen, kan een AI-model kleine afwijkingen suggereren die niet aanwezig zijn.
Onze beoordeling van ChatGPT
ChatGPT vond vier van de zeven wijzigingen duidelijk en herkende de veranderde muffins gedeeltelijk. Twee verschillen werden helemaal gemist.
Positief is dat het model onzekerheid benoemde. Minder sterk is dat het ook verschillende niet-bestaande afwijkingen suggereerde.
Het oorspronkelijke antwoord van ChatGPT: Hieronder zie je een screenshot van de verschillen die ChatGPT ontdekte. Je kunt ook zien hoe het model omging met kleinere, onzekere afwijkingen.
Resultaat 2 • Gemini
Gemini vindt zes van de zeven verschillen en verzint er geen
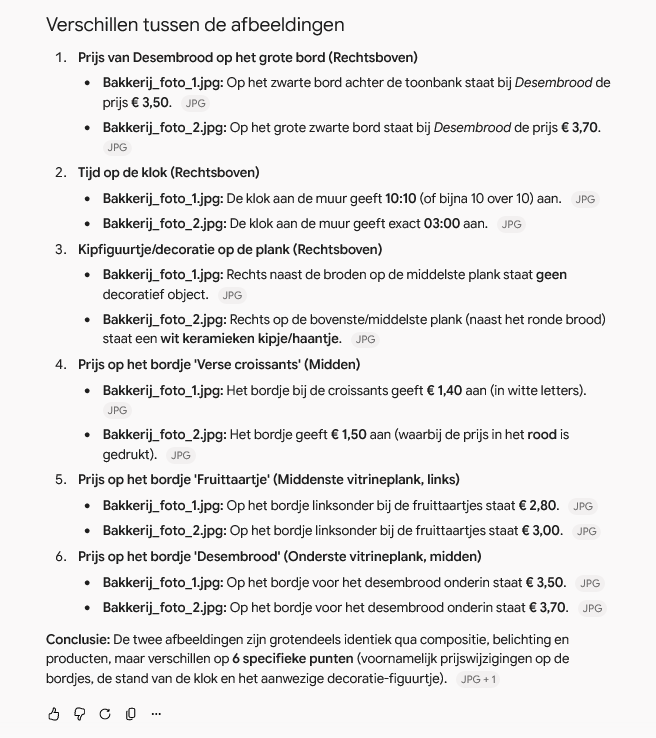
Gemini leverde een overzichtelijk antwoord met zes concrete verschillen, telkens met de locatie en een beschrijving van wat er was veranderd.
Het model herkende:
- De gewijzigde prijs van desembrood op het grote krijtbord.
- De andere stand van de klok.
- Het witte keramieken kipje op de broodplank.
- De nieuwe prijs van de verse croissants.
- De prijswijziging bij het fruittaartje.
- De tweede prijswijziging bij desembrood, onderaan de vitrine.
Dat laatste is interessant. Gemini vond beide prijswijzigingen voor desembrood, hoewel die op verschillende plaatsen in de afbeelding stonden.
Het model merkte bovendien op dat de prijs bij de verse croissants niet alleen een ander bedrag had, maar ook in een andere kleur was weergegeven.
Welk verschil miste Gemini?
Gemini zag de gewijzigde muffins onder de glazen stolp niet.
Dat is opvallend, omdat dit verschil niet om kleine tekst of cijfers gaat, maar om het uiterlijk van de producten zelf.
Mogelijk kregen de duidelijke prijskaartjes en andere herkenbare wijzigingen meer aandacht in het antwoord. Waarom het model precies de muffins miste, kunnen we uit dit ene antwoord niet afleiden.
Onze beoordeling van Gemini
Met zes correct gevonden verschillen en geen verzonnen wijzigingen levert Gemini een sterk resultaat. Alleen de veranderde muffins werden volledig over het hoofd gezien.
Het oorspronkelijke antwoord van Gemini: Op de screenshot hieronder zie je hoe Gemini de zes gevonden verschillen opsomde en beschreef waar ze zich in de bakkerijfoto’s bevonden.
Resultaat 3 • Claude
Claude vindt alle zeven verschillen
Claude leverde in deze test het volledigste antwoord van de vier AI-modellen.
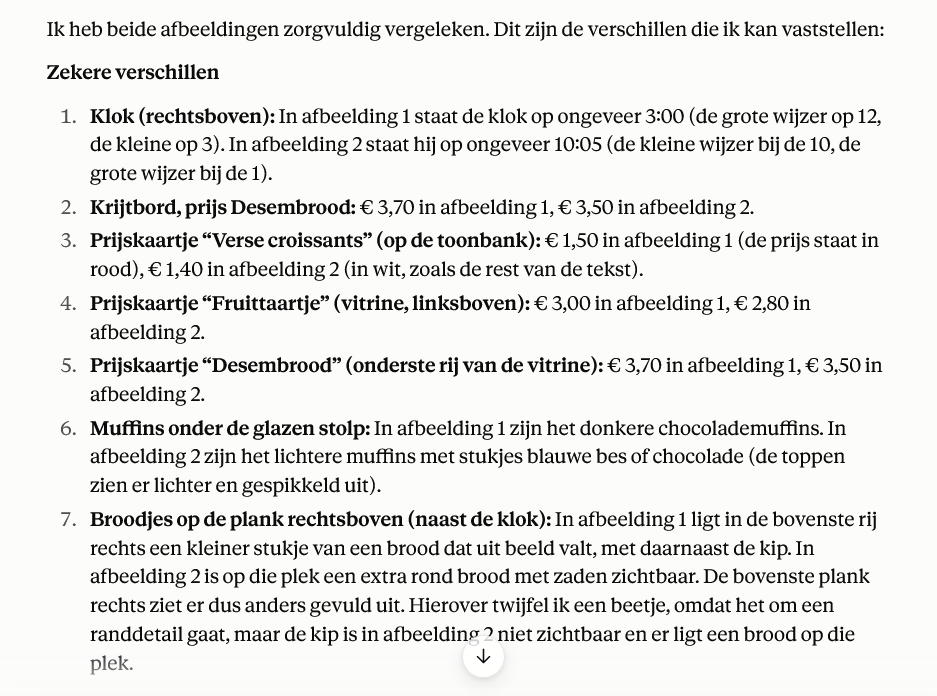
Het model noemde zeven verschillen en herkende daarmee alle wijzigingen die we bewust in de afbeeldingen hadden aangebracht.
Claude vond:
- De gewijzigde stand van de klok.
- De prijswijziging voor desembrood op het grote krijtbord.
- De gewijzigde prijs van de verse croissants.
- De prijswijziging bij het fruittaartje.
- De tweede prijswijziging voor desembrood onderaan de vitrine.
- Het verschil bij de muffins onder de glazen stolp.
- De verandering op de broodplank rechtsboven, met het keramieken kipje.
Vooral de herkenning van de muffins was interessant
Claude beschreef niet alleen dat er iets anders was onder de glazen stolp. Het model onderscheidde de donkere chocolademuffins van de lichtere muffins met zichtbare stukjes.
Dat is een belangrijk verschil met ChatGPT, dat wel een mogelijke verandering zag maar die niet correct beschreef, en Gemini, dat de muffins helemaal niet vermeldde.
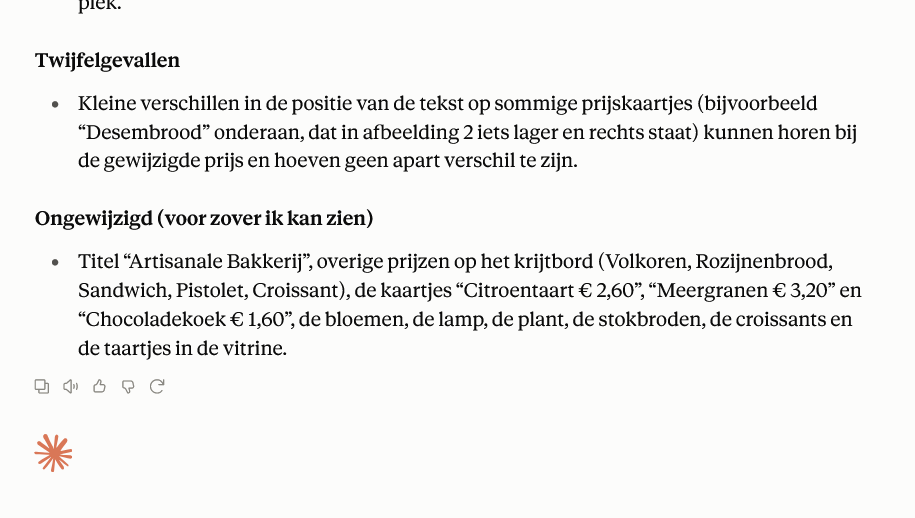
Ook de wijziging op de broodplank rechtsboven werd herkend. Claude beschreef die wat omslachtig en gaf aan hierover enige twijfel te hebben, maar wees wel de juiste veranderde plaats aan.
Claude maakte bovendien onderscheid tussen zekerheid en twijfel
Na de zeven gevonden verschillen vermeldde Claude nog een klein mogelijk verschil in de positie van tekst op sommige prijskaartjes.
Het model beschouwde dat zelf niet als een afzonderlijke wijziging. Dat was terecht: de aangepaste prijskaartjes telden al mee en er was geen extra verschil.
Vervolgens gaf Claude ook een overzicht van verschillende onderdelen die volgens het model ongewijzigd waren, zoals de andere broodprijzen, de bloemen, planten en baguettes.
Dat maakt Claude de duidelijke winnaar van deze specifieke praktijktest.
Het oorspronkelijke antwoord van Claude: Hieronder staat de screenshot van Claudes antwoord. Het model herkende alle zeven verschillen en maakte daarbij onderscheid tussen zekere vaststellingen en twijfelgevallen.
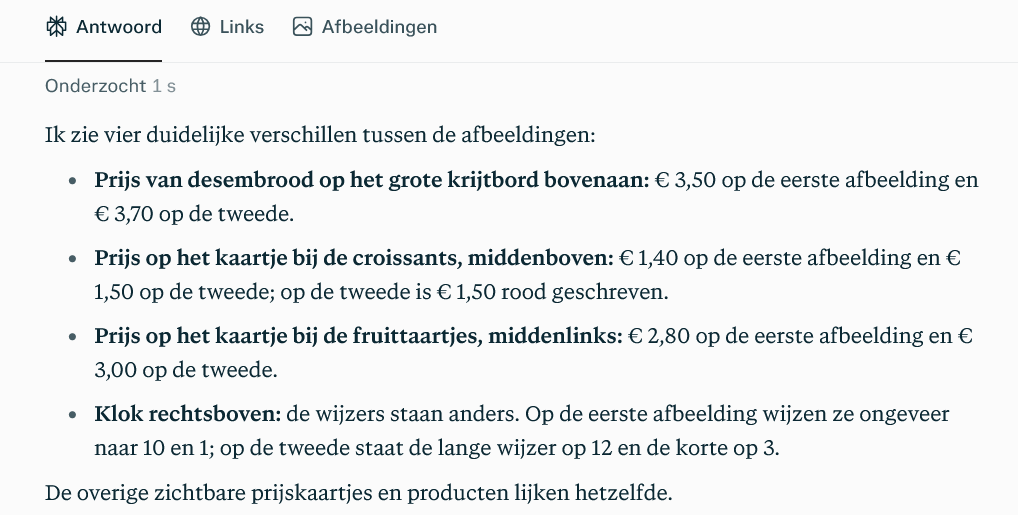
Resultaat 4 • Perplexity
Perplexity vindt vier verschillen, maar mist er drie
Perplexity gaf een opvallend kort antwoord. Het model noemde vier duidelijke verschillen en beschreef die correct.
Het herkende:
- De gewijzigde prijs van desembrood op het grote krijtbord.
- De prijswijziging bij de verse croissants.
- De prijswijziging bij het fruittaartje.
- De veranderde stand van de klok.
Daarmee vond Perplexity dezelfde vier duidelijke verschillen die ook ChatGPT correct herkende.
Welke verschillen werden gemist?
Perplexity merkte drie werkelijke wijzigingen niet op:
- Het witte keramieken kipje op de broodplank.
- De tweede prijswijziging voor desembrood onderaan de vitrine.
- De gewijzigde muffins onder de glazen stolp.
Vooral de gemiste tweede prijswijziging is opmerkelijk. Het model zag de wijziging voor desembrood op het grote krijtbord, maar niet op het afzonderlijke kaartje onderaan.
Het antwoord eindigde met de mededeling dat de overige zichtbare prijskaartjes en producten hetzelfde leken.
Dat was niet correct. Er waren immers nog drie andere werkelijke verschillen.
Wel positief: geen verzonnen verschillen
Perplexity noemde uitsluitend verschillen die echt aanwezig waren.
Het model bleef dus terughoudend en probeerde het overzicht niet aan te vullen met onzekere of verzonnen afwijkingen.
Het oorspronkelijke antwoord van Perplexity: Op onderstaande screenshot zie je het beknopte antwoord van Perplexity, waarin het model vier verschillen identificeerde en de overige wijzigingen niet vermeldde.
De vergelijking
Welk AI-model vond de meeste verschillen?
De resultaten van de vier modellen verschillen duidelijk.
Claude ontdekte alle zeven wijzigingen. Gemini vond er zes. ChatGPT herkende vier verschillen duidelijk en één gedeeltelijk. Perplexity vond vier verschillen.
De resultaten in één overzicht
Vond alle bewuste wijzigingen, inclusief de muffins en het kleine decoratieve voorwerp op de broodplank.
Herkende alle wijzigingen behalve de muffins en verzon geen andere verschillen.
Herkende de muffins gedeeltelijk, miste twee verschillen volledig en suggereerde enkele niet-bestaande kleine afwijkingen.
Beschreef vier wijzigingen correct, maar miste het kipje, de tweede prijswijziging bij desembrood en de gewijzigde muffins.
Welke verschillen werden precies ontdekt?
| Verschil | ChatGPT | Gemini | Claude | Perplexity |
|---|---|---|---|---|
| Desembrood groot bord | Ja | Ja | Ja | Ja |
| Klok | Ja | Ja | Ja | Ja |
| Keramieken kipje | Nee | Ja | Ja | Nee |
| Prijs croissants | Ja | Ja | Ja | Ja |
| Prijs fruittaartje | Ja | Ja | Ja | Ja |
| Desembrood onderaan | Nee | Ja | Ja | Nee |
| Andere muffins | Deels | Nee | Ja | Nee |
| Totaal | 4 + 1 deels | 6/7 | 7/7 | 4/7 |
“Deels” betekent dat het model de juiste plaats als mogelijk veranderd aanwees, maar niet correct beschreef welke inhoudelijke wijziging daar was aangebracht.
En hoe zit het met verzonnen verschillen?
Hier zien we een ander onderscheid tussen de modellen.
Gemini en Perplexity hielden zich aan de werkelijk aanwezige wijzigingen. Claude vond alle zeven en benoemde nog een klein twijfelgeval, maar presenteerde dat niet als een extra verschil.
ChatGPT suggereerde daarentegen enkele kleine verschillen in de vorm of positionering van brood en gebak die niet waren aangebracht.
Wat kunnen we hieruit leren?
Een AI-model dat afbeeldingen kan bekijken, ziet niet noodzakelijk ieder detail
AI-modellen kunnen tegenwoordig veel met afbeeldingen. Ze herkennen voorwerpen, beschrijven scènes, lezen tekst en kunnen verschillende beelden analyseren.
Maar onze test toont dat je niet zomaar mag aannemen dat een AI-model ook iedere kleine verandering tussen twee afbeeldingen ontdekt.
1. Een verschil vinden is niet hetzelfde als alle verschillen vinden
Alle vier de modellen ontdekten meerdere correcte wijzigingen. Dat betekent echter niet dat ze de volledige vergelijking goed uitvoerden.
Perplexity noemde bijvoorbeeld vier correcte verschillen, maar miste drie andere. Wanneer je het juiste aantal vooraf niet kent, kan zo’n antwoord toch volledig lijken.
Dat is misschien wel een van de belangrijkste aandachtspunten bij het gebruik van AI voor kwaliteitscontrole.
2. Kleine tekstwijzigingen en visuele wijzigingen vragen aandacht
We hadden bewust verschillende soorten veranderingen aangebracht: prijzen, een klok, een decoratief voorwerp en andere muffins.
De vier modellen vonden allemaal de drie duidelijkst herkende prijswijzigingen en de verandering van de klok.
Maar de andere wijzigingen werden niet door iedereen opgemerkt. Vooral de muffins bleken lastig: alleen Claude herkende dat verschil volledig.
Dit illustreert waarom het nuttig kan zijn om bij een belangrijke controle niet uitsluitend te vertrouwen op de eerste vergelijking die een AI-model geeft.
3. Ook niet-bestaande verschillen zijn belangrijk
Wanneer AI iets niet ziet, is dat één soort fout. Maar er bestaat ook een omgekeerd probleem: een model kan menen een verschil te zien terwijl beide onderdelen identiek zijn.
Dat zagen we bij ChatGPT. Het model suggereerde kleine afwijkingen bij producten die helemaal niet veranderd waren.
Het ging voorzichtig om met die onzekerheid, maar juist daarom is het belangrijk dat de gebruiker een mogelijk verschil niet automatisch als een bevestigd feit behandelt.
4. Deze techniek kan nuttig zijn voor gewone gebruikers en ondernemers
Stel dat je twee versies van een reclameaffiche wilt vergelijken. Misschien is er een prijs veranderd, ontbreekt een product of is een stukje tekst onbedoeld aangepast.
Of denk aan een ondernemer die twee productafbeeldingen, verpakkingsontwerpen of versies van een winkelpresentatie naast elkaar wil leggen.
AI kan helpen om mogelijke verschillen sneller onder de aandacht te brengen.
Maar wanneer de controle belangrijk is, bijvoorbeeld bij prijzen, technische tekeningen of drukwerk, blijft een afzonderlijke menselijke controle noodzakelijk.
Vraag AI niet alleen om verschillen op te sommen, maar ook om de exacte locatie te vermelden en twijfel duidelijk te benoemen.
Controleer belangrijke wijzigingen vervolgens zelf. Een overtuigend AI-antwoord is niet noodzakelijk een volledige of foutloze vergelijking.
Onze conclusie
Claude wint deze zoek-de-verschillen-test met een perfecte 7 op 7
We maakten twee bijna identieke afbeeldingen van een bakkerij en brachten zeven bewuste verschillen aan. Vervolgens vroegen we ChatGPT, Gemini, Claude en Perplexity om alle wijzigingen te vinden.
De verschillen in prestaties waren duidelijk.
Claude vond alle zeven verschillen en was daarmee het volledigste model in deze test.
Gemini volgde met zes correct herkende wijzigingen. ChatGPT vond vier verschillen duidelijk en één gedeeltelijk, terwijl Perplexity vier wijzigingen ontdekte.
Daarnaast viel op dat ChatGPT enkele niet-bestaande kleine afwijkingen suggereerde. De andere modellen bleven op dat vlak terughoudender.
Wat is de belangrijkste les?
AI kan verschillen herkennen, maar een gedeeltelijk correct antwoord kan gemakkelijk de indruk wekken dat de volledige vergelijking geslaagd is.
Vooral wanneer je vooraf niet weet hoeveel verschillen er zijn, is het lastig om te beoordelen of de AI werkelijk alles heeft gevonden.
Daarom blijft het verstandig om belangrijke details zelf te controleren, zeker bij prijzen, documenten en andere afbeeldingen waarbij nauwkeurigheid belangrijk is.
Claude was het sterkst in deze specifieke opdracht. Gemini leverde eveneens een goed resultaat. ChatGPT en Perplexity vonden verschillende echte wijzigingen, maar misten een belangrijk deel van de test.
Het aantal gevonden verschillen zegt daarbij meer dan hoe uitgebreid of overtuigend het antwoord geschreven is.
Deze test is gebaseerd op één afbeeldingspaar en één uitvoering per AI-model. De resultaten geven geen algemene rangschikking van de vier modellen en kunnen bij andere afbeeldingen of latere modelversies anders zijn.